
Profils des enquêtés#
Les statuts représentés#
Les personnes ayant répondu à l’enquête sont majoritairement des enseignants-chercheurs ou des chercheurs (87%), 10% d’entre elles sont des doctorants, tandis que les personnels d’appui à la recherche (ingénieur d’étude et de recherche) représentent 3% de l’effectif total.
q25_statut_rec |
nb |
freq |
|---|---|---|
Chercheur |
104 |
87,4 |
Doctorant |
12 |
10,1 |
Personnel d’appui à la recherche |
3 |
2,5 |
Total |
119 |
100,0 |
Cultures épistémiques#
Les laboratoires et les UFR représentés#
Un peu moins de 50% des personnes interrogées ont accepté de donner des informations sur leur ufr ou laboratoire de rattachement. Ces informations ont été collectées à l’aide de la dernière question proposant aux participants de laisser leurs coordonnées afin de poursuivre les échanges ultérieurement (Fig. 1).
Fig. 1 Demande des coordonnées des personnes enquêtées#
Étant donné que les réponses se présentent sous la forme de texte libre, nous les avons analysées à la main pour extraire le nom de l’UFR, du laboratoire, du département et parfois de l’école doctorale. Nous avons ensuite complété les données manquantes concernant les laboratoires et les UFR à partir d’informations trouvées sur le Web pour les répondants ayant laissé leur prénom et nom. Grâce à ce travail, nous connaissons les affiliations d’une cinquantaine de personnes : 57 pour les laboratoire (Table 2) et 54 pour les UFR (Table 3).
Les laboratoires les plus représentés (Table 2) sont Paragraphe (7%), le Laboratoire d’économie dyonisien (LED, 6%), l’unité de recherche Fonctionnement et Dysfonctionnement Cognitifs (DYSCO, 4%), le LADYSS (3%) et le Centre d’études sur les médias, les technologies et l’internationalisation (CEMTI, 3%). Mis à part le DYSCO, ce sont quatre laboratoires au sein desquels la bibliothèque dispose de “référents données”. Concernant les UFR (Table 3), celui de psychologie est le plus représenté avec 13 personnes, soit 10% des répondants. 4% des répondants sont rattachés à l’UFR Erites (études, recherche et ingénierie en territoires – environnements – sociétés). On compte la même proportion pour les UFR AES économie-gestion et Textes et sociétés.
labo |
nb |
freq |
|---|---|---|
paragraphe |
8 |
6.7 |
led |
7 |
5.9 |
dysco |
5 |
4.2 |
ladyss |
4 |
3.4 |
cemti |
4 |
3.4 |
lapps |
3 |
2.5 |
transcrit |
3 |
2.5 |
chart |
3 |
2.5 |
aiac |
3 |
2.5 |
idhes |
3 |
2.5 |
liasd |
2 |
1.7 |
sfl |
2 |
1.7 |
cresppa |
2 |
1.7 |
circeft |
1 |
0.8 |
arscan |
1 |
0.8 |
crjp8 |
1 |
0.8 |
laboratoire d’études romanes |
1 |
0.8 |
ihtp |
1 |
0.8 |
legs |
1 |
0.8 |
liage |
1 |
0.8 |
musidanse |
1 |
0.8 |
Non réponse |
62 |
52,1 |
ufr |
Effectifs absolus |
Fréquences relatives |
|---|---|---|
psychologie |
13 |
10,9 |
erites |
5 |
4,2 |
aes economie gestion |
5 |
4,2 |
textes et sociétés |
5 |
4,2 |
llce lea |
4 |
3,4 |
culture et communication |
4 |
3,4 |
arts |
4 |
3,4 |
mitsic |
4 |
3,4 |
sdl |
2 |
1,7 |
sepf |
2 |
1,7 |
droit |
1 |
0,8 |
iut tremblay-en-france |
1 |
0,8 |
iee |
1 |
0,8 |
mitsic |
1 |
0,8 |
le |
1 |
0,8 |
Non réponses |
65 |
54,6 |
Total |
119 |
100,0 |
Champs disciplinaires#
Nous avons également demandé aux participant de préciser leurs champs de recherches à l’aide de la nomenclature définie par l’European Research Council (ERC). Cette nomenclature compte 22 modalités.
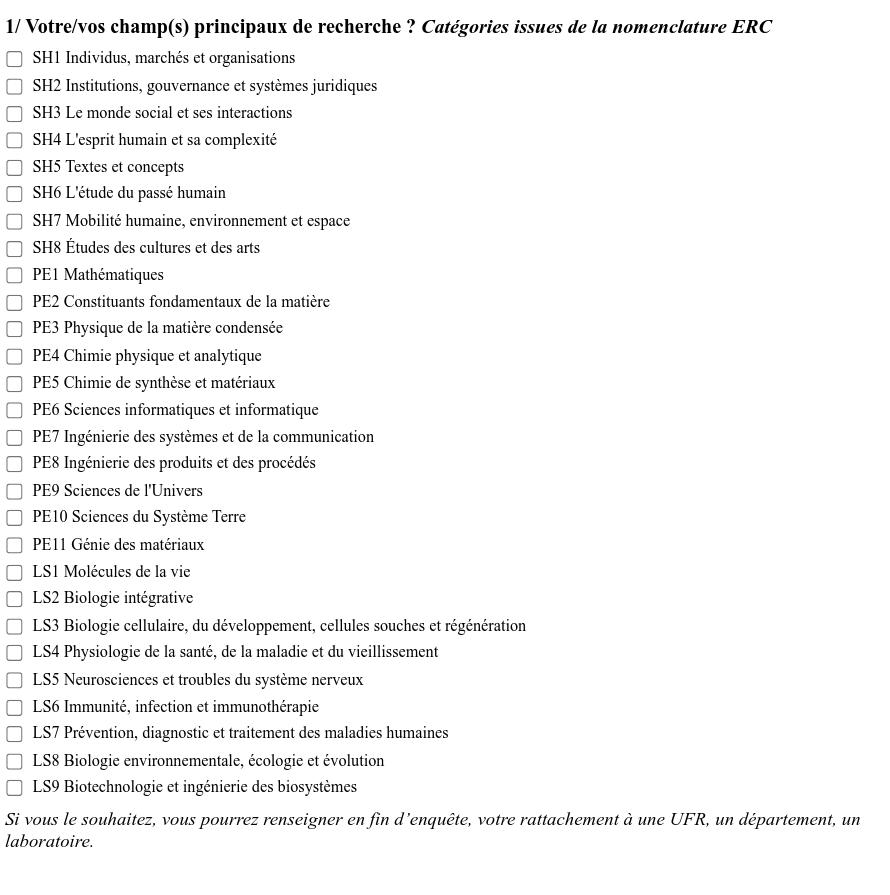
Fig. 2 Les champs de recherche, une question à choix multiples#
Sans surprise pour une université ancrée dans les sciences humaines et sociales, 92% des répondants appartiennent à un champ des “sciences sociales et humaines” et plus de la moitié s’inscrivent dans le champ intitulé “SH3 Le mond social et ses interactions” (Fig. 3). On observe aussi la présense des sciences informatiques et des mathématiques, ainsi que des neurosciences.
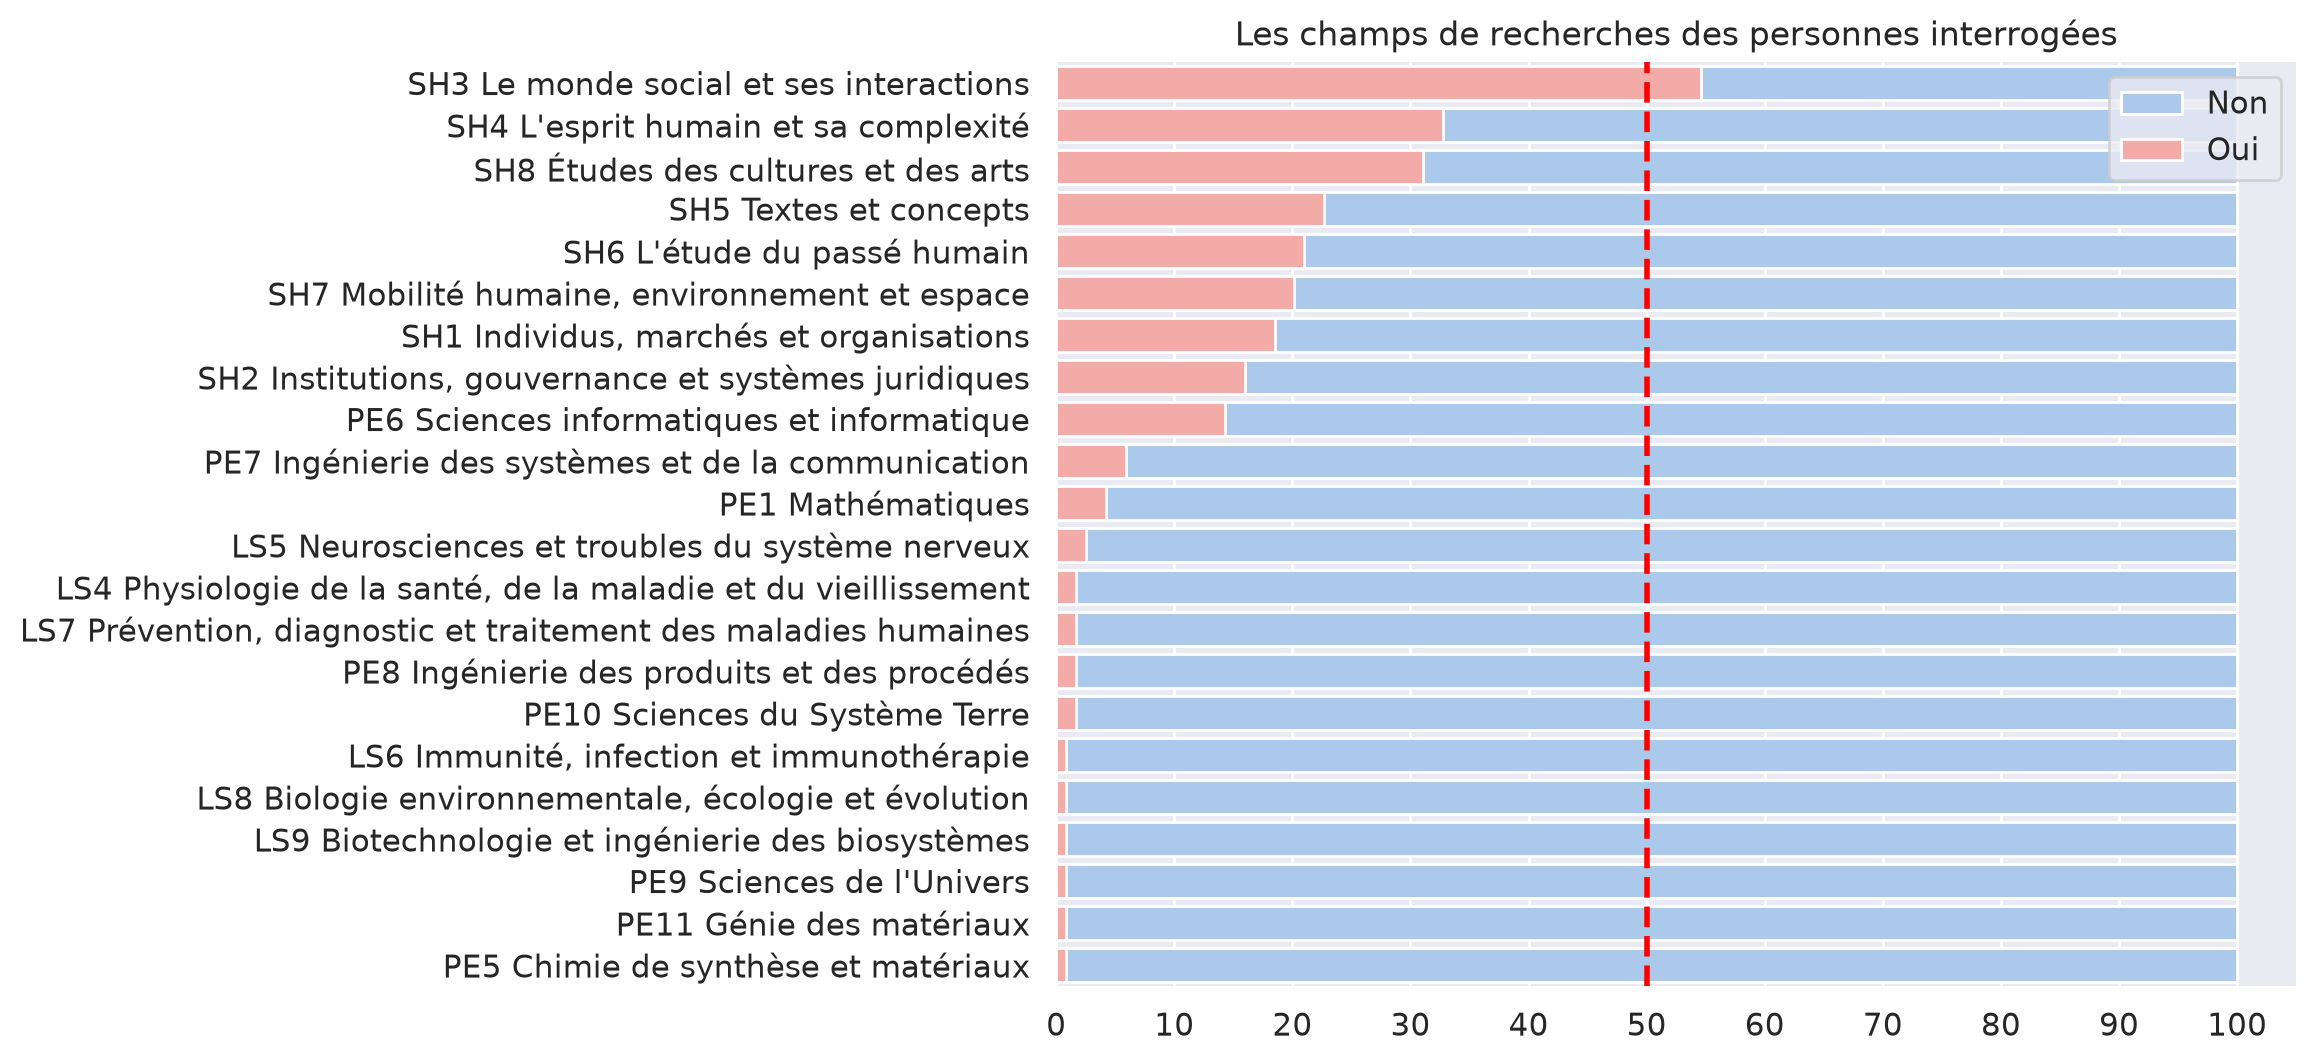
Fig. 3 Les champs de recherche des répondants#
Les lieux de travail#
Afin de connaître les pratiques de travail des répondants, nous leur avons d’abord demandé où ils travaillaient le plus souvent en classant par ordre de priorité les trois modalités suivantes :
“À mon domicile”
“Dans mon bureau sur site”
“Autre”
71% des personnes interrogées ont cité leur domicile en premier (Table 4). Le domicile constitue par ailleurs un lieu de travail pour 90% des répondants, quelque soit l’ordre dans lequel il a été placé. En comparaison, le “bureau sur site” arrive en première position dans 24% des cas et il est utilisé comme lieu de travail par 59% des répondants.
Parmis les autres lieux cités, on trouve tout d’abord les bibliothèques et les sites d’autres organisation (CNRS, Campus Condorcet, partenaires de recherche). Plusieurs répondants ont également indiqué qu’ils travaillaient “un peu partout”, faute de bureaux disponibles sur le campus.
“Où je peux, puisque nous n’avon pas de bureaux.”
“Dans les bureaux de collègues dans d’autres universités”
“Au bureau de la MSH ou à la bibliothèque. Mais je manque cruellement d’un espace de travail.”
“Où je peux, je n’ai pas de bureau à la fac (15 m2 pour 6 titulaires).”
Ces réactions recoupent les résultats observés concernant les services à développer, puisque 80% des répondants estiment qu’il serait utile de développer des espaces de travail (Fig. 15).
Lieu de travail |
Rang |
Effectifs |
fréquences (%, total des répondants) |
|---|---|---|---|
A mon domicile |
Tous rangs confondus |
108 |
90,76 |
1 |
85 |
71,43 |
|
2 |
20 |
16,81 |
|
3 |
3 |
2,52 |
|
Dans mon bureau sur site |
Tous rangs confondus |
70 |
58,82 |
1 |
29 |
24,37 |
|
2 |
36 |
30,25 |
|
3 |
5 |
4,20 |
|
Autre, précisez |
Tous rangs confondus |
31 |
26,05 |
1 |
5 |
4,20 |
|
2 |
12 |
10,08 |
|
3 |
14 |
11,76 |
Les systèmes d’exploitation#
Les systèmes d’exploitation les plus répandus sont Apple et Windows. Seules 8 personnes utilisent Linux. En ce qui concerne les navigateurs, Firefox est le plus populaire. Il est cité par 52% des répondants. Chrome vient ensuite avec 23% des répondants qui l’utilisent.
Systèmes d’exploitation |
Effectifs |
Frequences (%) |
|---|---|---|
Apple |
53 |
44,5 |
ChromeOS |
4 |
3,4 |
Linux |
8 |
6,7 |
Windows |
54 |
45,4 |
Total |
119 |
100,0 |
Navigateurs |
Effectifs |
Frequences (%) |
|---|---|---|
Firefox |
62 |
52,1 |
Chrome |
28 |
23,53 |
Safari |
17 |
14,29 |
Autre, précisez |
6 |
5,04 |
Chromium |
3 |
2,52 |
Tor browser |
2 |
1,68 |
Edge |
1 |
0,84 |
Total |
119 |
100,00 |
Utilisation de l’IA#
68 répondants (soit 57%) disent avoir recourt à l’intelligence artificielle pour leurs recherches, dont 65% utilisent des versions gratuites. La même proportion cite Chat GPT. Il est l’outil le plus utilisé.
Outils IA |
nb |
total |
freq |
|---|---|---|---|
chatgpt |
42 |
65 |
64,6 |
claude |
19 |
65 |
29,2 |
deepl |
7 |
65 |
10,8 |
gemini |
7 |
65 |
10,8 |
mistral |
6 |
65 |
9,2 |
67 de ces 68 personnes ont ensuite répondu à la question “pourquoi les utilisez-vous ?”. Une première lecture des réponses nous a permis de constater que les répondants mobilisaient parfois plusieurs raisons pour justifier leur utilisationde l’intelligence artificielle. Il nous a alors semblé intéressant de recourir à un algorithme de “topic modeling” afin d’identifier les “répertoires de motifs” idéaltypiques. L’algorithme choisi est BERTopic [Grootendorst, n.d.]. S’appuyant sur des modèles de plongement de mots (word embedding) de type sentence-transformers, BERTopic est réputé pour être plus perfomant que des modèles traditionnels comme le Latent Dirichlet Allocation (LDA) lorsqu’il s’agit d’extraire des thématiques à partir d’un corpus de phrases courtes. Ce qui est le cas ici puisque la réponse la plus longue apportée à la question “pourquoi les utilisez-vous ?” est de 37 mots.
Une fois le plongement de mot effectué à partir d’un modèle pré-entrainé, l’algorithme BERTopic réduit la dimensionalité de l’embedding avec UMAP et extrait les clusters (groupe de réponses) avec la méthode HDBSCAN. Pour finir, l’aglorithme propose une labellisation en prenant les termes les plus spécificiques de chacun des clusters. Cette spécificité est calculée via un dérivé du TF-IDF (Term frequency-inverse document frequency) où l‘“unité de référence” n’est plus le document, mais le cluster.
Le détail du traitement effectué est disponible ici : luneauaymeric/enquete_SO_p8
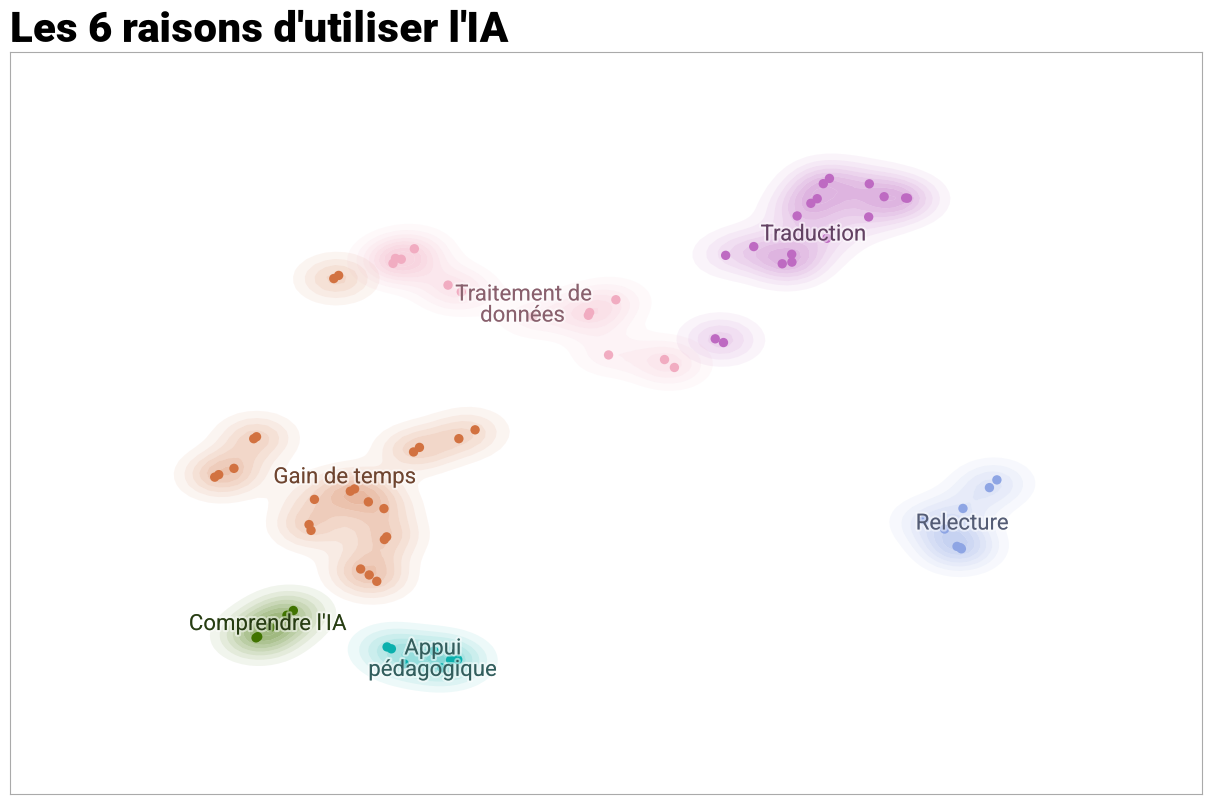
Fig. 4 6 raisons d’utiliser l’IA#
L’analyse fait ressortir six raisons “idéaltypiques” avancés par les personnes enquêtées pour expliquer leur utilisation de l’IA. La raison qui revient le plus souvent est le “gain de temps”, que ce soit pour rédiger des e-mails, effectuer des tâches administratives ou rechercher de l’information :
“Pour gagner du temps sur des procédures routinières ou pour formaliser des courriels ou autres plus rapidement”
“Pour gagner du temps dans la recherche informations”
Les deux autres principales raisons sont :
l’aide à la traduction ;
“relecture de l’anglais principalement”
Le traitement et l’analyse des données ;
analyse et visualisation des données
analyse d’entretiens, recherche dans de multiples entretiens
L’IA est enfin utilisée pour :
relire et corriger des textes;
Relectures, améliorations du manuscrit
préparer des cours ou contrôler son utilisation par les étudiants ;
Enseignement: Structuration de cours, élaboration de syllabus, idées d’activités pédagogiques
comprendre ce que ces outils font ;
J’essaye de comprendre comment ils fonctionnent
Bien sûr, plusieurs raisons peuvent apparaître au sein d’une même réponse. Par exemple, un des répondants a écrit : “NoScribe en local pour des transcriptions d’entretiens et deepl pour des traductions courtes et ponctuelles”.